本ブログはJ-tau実装の更新に伴い、8月17日に更新されました。
はじめに
こんにちは、SB Intuitions株式会社でインターンをしている矢野千紘です。
近年、LLMの応用領域は多岐にわたっており、中でも自律的にタスクを遂行するエージェントは、特に大きな注目を集めている領域の一つです。しかし先行研究[Hofman et al., 2025]では、エージェント能力のベンチマークは評価言語に依存してスコアが変動することが報告されています。このことから、高性能な日本語LLMの開発においては、日本語エージェント能力の評価ベンチマークが不可欠です。
本ブログでは、広く利用されているエージェントベンチマークtau-benchのtelecomドメインを対象に、その日本語版であるJ-tau telecomを構築しました。さらに、このベンチマークを用いて多様なモデルの評価を行いました。
J-tau telecomはModified MITライセンスのもとで公開いたします。
コード:https://github.com/sbintuitions/j-tau-bench
J-tauの概要
J-tauは英語で整備されたエージェント能力を評価するベンチマークであるtau-benchの日本語版です。
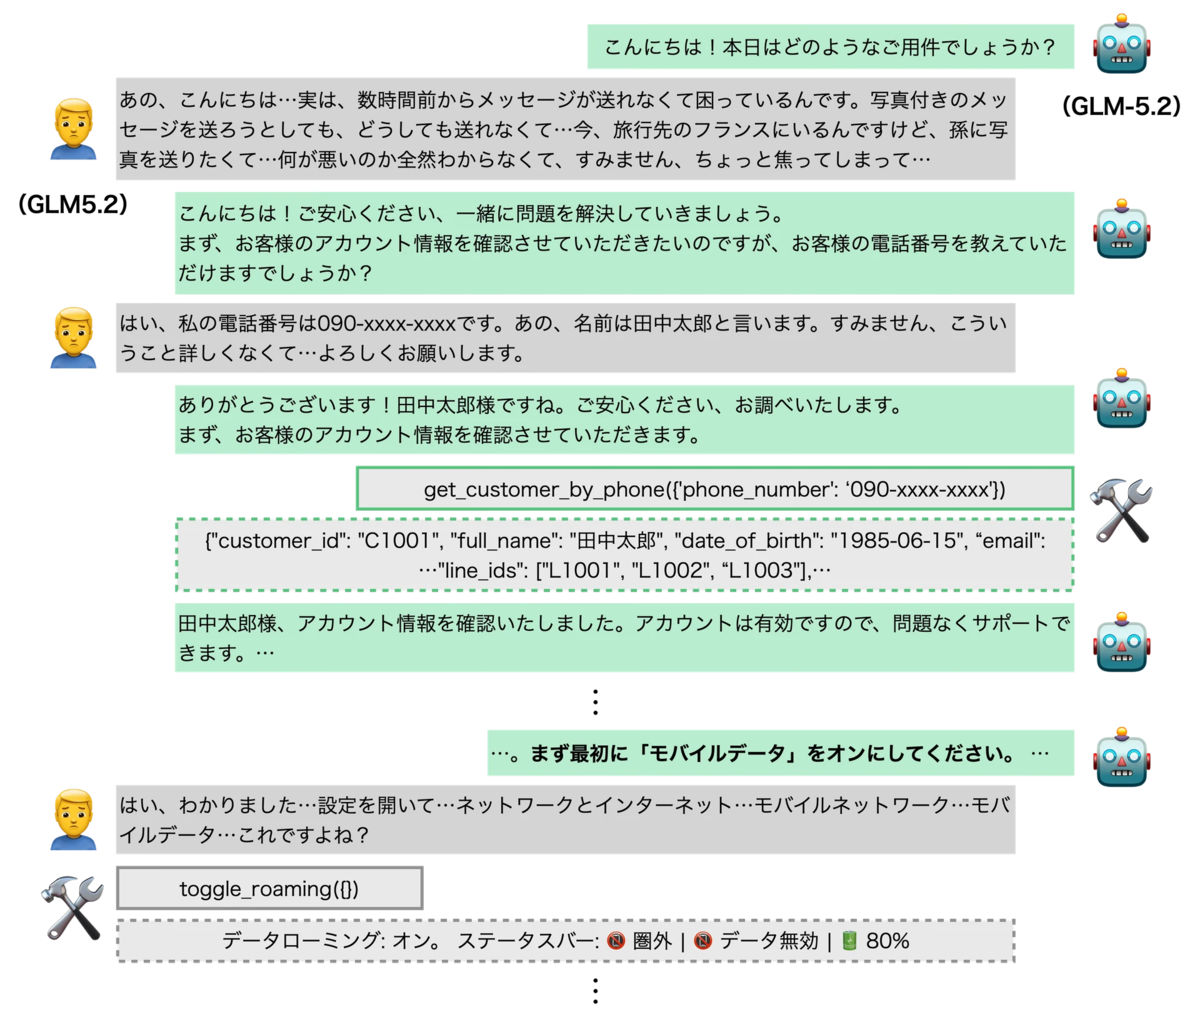
tau-benchの概要
tau-benchは4ドメインからなるLLMのエージェント能力を評価するベンチマークで、今回対象としたtelecomドメインは、通信事業のカスタマーサポートを題材としています。
実際のカスタマーサポートでは、オペレーターは顧客情報にアクセスしつつ、ユーザーに自身の端末を操作するよう指示を行う必要があります。telecomドメインはこの状況を模しており、ユーザーとエージェントが相互に作用する状況をシミュレーションします。
ユーザーとエージェントは同じ状態空間に対してアクションを行う、異なるツール集合を持っています。ツールは関数として定義されており、エージェントが利用可能なものとしては、顧客の電話番号から顧客情報を取得するget_customer_by_phoneなどが、ユーザーが利用可能なものとしては機内モードを変更するtoggle_airplane_modeなどがあります。
tau-bench telecomにはエージェントだけでなくユーザーも適切にツールを実行しなければ解決できないタスクが多く含まれており、エージェントモデルには自身がツールを利用する能力に加え、ユーザーのみが実行可能なツールについても理解し正しく指示をする能力が必要になります。
J-tauの構築
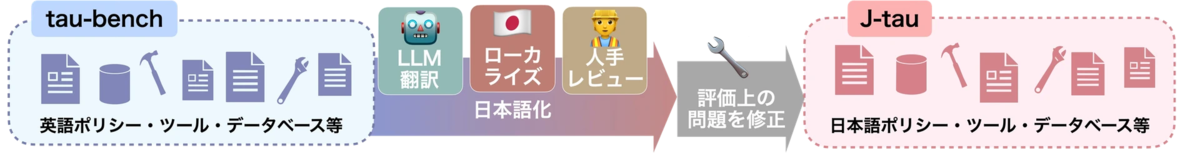
J-tauはtau-benchを日本語化し、評価上の問題をいくつか修正することで作成しました。評価上の問題については次の節で詳しく説明します。
日本語化はモデルに入力するドキュメントや、ツールの説明と返り値、顧客データベースなどを対象としました。日本語化はLLMによる自動翻訳と、顧客名など固有名詞のローカライズ、通信事業ドメインの専門家によるレビューによって行われ、レビューでは専門用語の対訳を中心に修正しました。
J-tauはユーザーとエージェントが相互に作用するベンチマークであるため、エージェントモデルの性能だけでなく、ユーザーモデルの振る舞いがシミュレーションの結果を左右してしまうことがあります。例えばJ-tauでは、ユーザーモデルがエージェントからのツール実行の指示に対し、”(操作中…)”のようなト書きを出力するだけでツールを呼ばないケースや、エージェントに次の行動を提案してしまうケースなどが見られます。このような挙動は、エージェントモデルを正しく評価できなくなる要因となります。
そこで対策として、ユーザーモデルに入力するガイドラインのみを翻訳せず、英語のまま入力する設定を検討しましたが、大きな改善は見られませんでした。次に、複数のモデルを比較して最適なユーザーモデルの探索を行い、不要な提案が最も少なく、エージェントモデルの性能をストレートに評価できるモデルとしてGLM-5.2を選定しました。
一部のシミュレーションでは課題が残るものの翻訳前のtau-benchでも同様の現象が発生しており、その頻度もほぼ変わらないことから、評価の妥当性は確保されていると判断し、J-tauではこれを許容することにしました。
評価フレームワークの修正
tau-benchでは、空応答やtool callにおけるJSONの破損など、明らかにモデル自身の失敗である挙動が、モデルの能力不足ではなくINFRASTRUCTURE_ERRORとして扱われ、3回リトライした後にスコア計算から除外されていました。そのため、本来失敗シミュレーションとしてスコアを下げる方向で計上されるべきタスクが集計の対象外になってしまっており、特に空応答を頻繁に出力するいくつかのモデルの性能が不当に高く評価されてしまっていました。
そこでJ-tauでは、空応答や破損したtool呼び出しが出力された時点でリトライを行わず、モデル自身のエラーとして即座にスコア0で計上するよう修正しました。これにより、モデルの能力不足が隠蔽されず、評価結果に反映されるようになりました。
評価実験
複数のLLMをJ-tau telecom(以後、J-tauと呼ぶ)、オリジナルのtau-bench telecom(以後、tauと呼ぶ)、評価フレームワークをJ-tauと同様に修正したtau-bench* telecom(以後、tau*と呼ぶ)によって評価し、比較を行います。
ユーザーモデルはGLM5.2を利用し、reasoning_effortについては、gpt-ossではhighに設定し、その他のモデルではデフォルト値を利用しました。3回実験した平均値を報告します。
|
model |
reasoning |
J-tau (日本語) |
tau-bench* |
Δtau*-Jtau |
tau-bench (英語) |
|
商用モデル |
|
|
|
|
|
|
claude-opus-4-8 |
high |
83.3% |
92.1% |
8.8% |
86.3% |
|
gemini-3.1-pro-preview |
high |
82.2% |
91.6% |
9.4% |
92.1% |
|
gpt-5.6 Sol |
medium |
93.6% |
85.1% |
-8.5% |
82.7% |
|
オープンモデル |
|
|
|
|
|
|
GLM-5.2 |
✔︎ |
96.5% |
98.2% |
1.70% |
98.8% |
|
Gemma 4 E2B |
✔︎ |
14.6% |
9.6% |
-5.0% |
28.1% |
|
Gemma 4 E4B |
✔︎ |
23.1% |
14.6% |
-8.5% |
37.3% |
|
Gemma 4 31B |
✔︎ |
45.0% |
73.7% |
28.7% |
74.6% |
|
gpt-oss-20b |
high |
62.3% |
76.6% |
14.3% |
83.0% |
|
gpt-oss-120b |
high |
63.5% |
92.7% |
29.2% |
92.4% |
|
Qwen3 4B |
✔︎ |
26.6% |
27.2% |
0.6% |
29.8% |
|
Qwen3 8B |
✔︎ |
32.7% |
49.7% |
17.0% |
48.8% |
|
Qwen3 14B |
✔︎ |
31.6% |
52.0% |
20.4% |
50.3% |
|
Qwen3 32B |
✔︎ |
34.2% |
45.0% |
10.8% |
41.2% |
|
Qwen3.5 4B |
✔︎ |
29.8% |
52.0% |
22.2% |
98.7% |
|
Qwen3.5 9B |
✔︎ |
50.3% |
80.1% |
29.8% |
96.5% |
|
Qwen3.5 27B |
✔︎ |
90.1% |
97.4% |
7.3% |
99.1% |
多くのモデルでtau*よりもJ-tauの方が低い性能を示しており、エージェント能力は評価言語に強く影響を受けることがわかります。
GLM5.2やgpt-5.6などのモデルはJ-tauでも高い性能を示しており、評価言語に対して頑健であることがわかりました。一方で、gemini-3.1-proやclaude-opus-4.8など、私たちが普段利用しているような商用モデルでもJ-tauで大きくスコアが劣化しており、入力言語が性能に影響を与える様子が観察されました。
このように、日本語におけるエージェント能力の発展には、まだまだ伸び代が残されていることがわかります。
また、ほとんどのモデルでtauよりもtau*の方が低い性能を示しており、集計を修正したことによる影響が見られます。特にQwen3.5-4B、9Bは修正前のtauでほとんど100%に近い性能を示していましたが、tau*ではそれぞれ52%、80%程度の性能にとどまっています。これらのモデルでは空応答を出力するケースがよく見られ、tauの集計によって不当に高い性能を示していたことがわかりました。
一部のモデルではtau*がtauよりも高いスコアを示していますが、これらのモデルは空応答をほとんど出力しないため集計の修正による影響が小さく、評価のブレがそのまま結果に反映されているのだと考えられます。
以降では、オープンモデルの言語間差分について注目し、結果を見ていきます。
言語間スコア差とモデルサイズ、既存の日本語ベンチマークスコアの関係
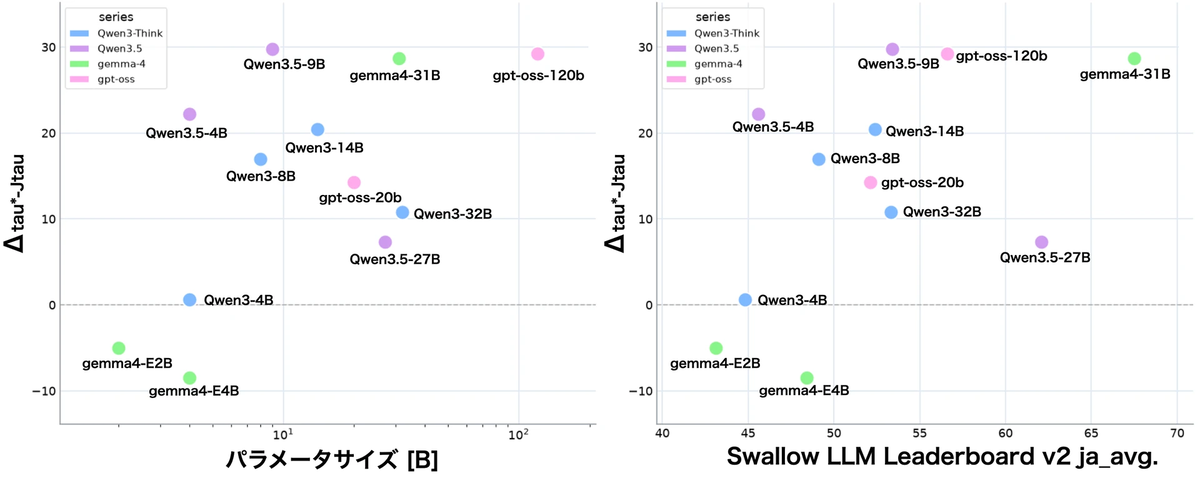
評価言語を日本語に変更したことによる性能の低下は、言語を超えて汎化しやすい巨大なモデルや、日本語能力の高いモデルの方が小さいと考えられます。
そこで、評価言語を変更したことによるスコア差分とモデルのパラメータサイズ、モデルの日本語能力の関連について分析します。言語間のスコア差分とモデルサイズ、言語間のスコア差分と日本語ベンチマークスコアをプロットした結果を図3に示します。既存の日本語ベンチマークスコアとしては、Swallow LLM Leaderboard v2で公開されている日本語事後学習タスクの平均値を利用しました。事後学習タスクにはJamC-QA、WMT20 (en->ja)、WMT20 (ja->en)、M-IFEval-Ja、MMLU-ProX、GPQA (ja)、PolyMath (ja, HT)、JHumanEvalが含まれています。
図3から、モデルサイズと日本語ベンチマークスコアの両方について、評価言語を変更したことによる性能の差分との明確な相関は見られませんでした。
モデルサイズについては同モデルシリーズ内でモデルサイズを大きくすることで、J-tauでのスコアが向上し、モデルサイズとJ-tauスコア自体には相関が見られました。一方で、tau*スコアも同時に向上していたため、評価言語の変更による差分とモデルサイズの間には明確な関連が見られませんでした。
日本語ベンチマークスコアについては、例えばGemma 4 31Bは、高い日本語ベンチマークスコアが報告されているにもかかわらず、評価言語を日本語に変更したことによる性能の劣化は同シリーズの他モデルよりも大きいという結果になりました。
以上より、評価言語を変更したことによる性能の変動幅は、モデルサイズや評価言語単体でのベンチマーク性能とは必ずしも相関しないことがわかりました。日本語エージェントとしてのモデルの能力は、既存の英語エージェントベンチマークスコアや日本語ベンチマークスコアから予測することは難しく、直接評価することが重要だとわかります。
タスクごとの正答率相関
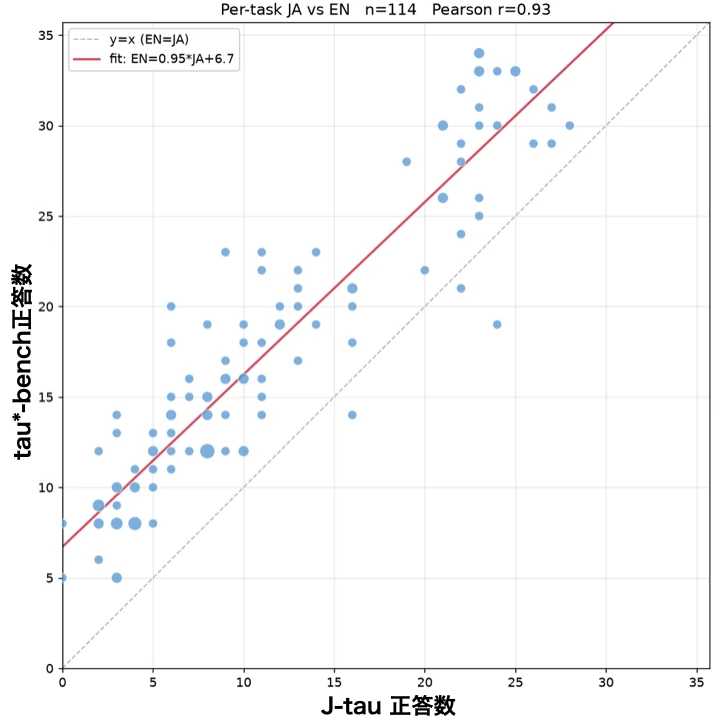
J-tau telecomはtau-bench* telecomの翻訳版ですが、評価タスク自体は同じもので構成されています。そのため、同じモデル群を評価した場合、評価言語による性能の変動は存在しつつも、各タスクの相対的な難易度はある程度一定であると考えられます。
そこで各タスクについて、相対的なタスク難易度を評価するために、13モデルによる3回ずつの実験結果から、英語と日本語それぞれについて正答数の合計を図4にプロットしました。すると強い正の相関が見られ、翻訳によってほとんどの問題で相対的な難易度が維持されていることがわかりました。
実際のシミュレーション例
実際にJ-tau telecomで評価を行った際のシミュレーション例をいくつか示します。
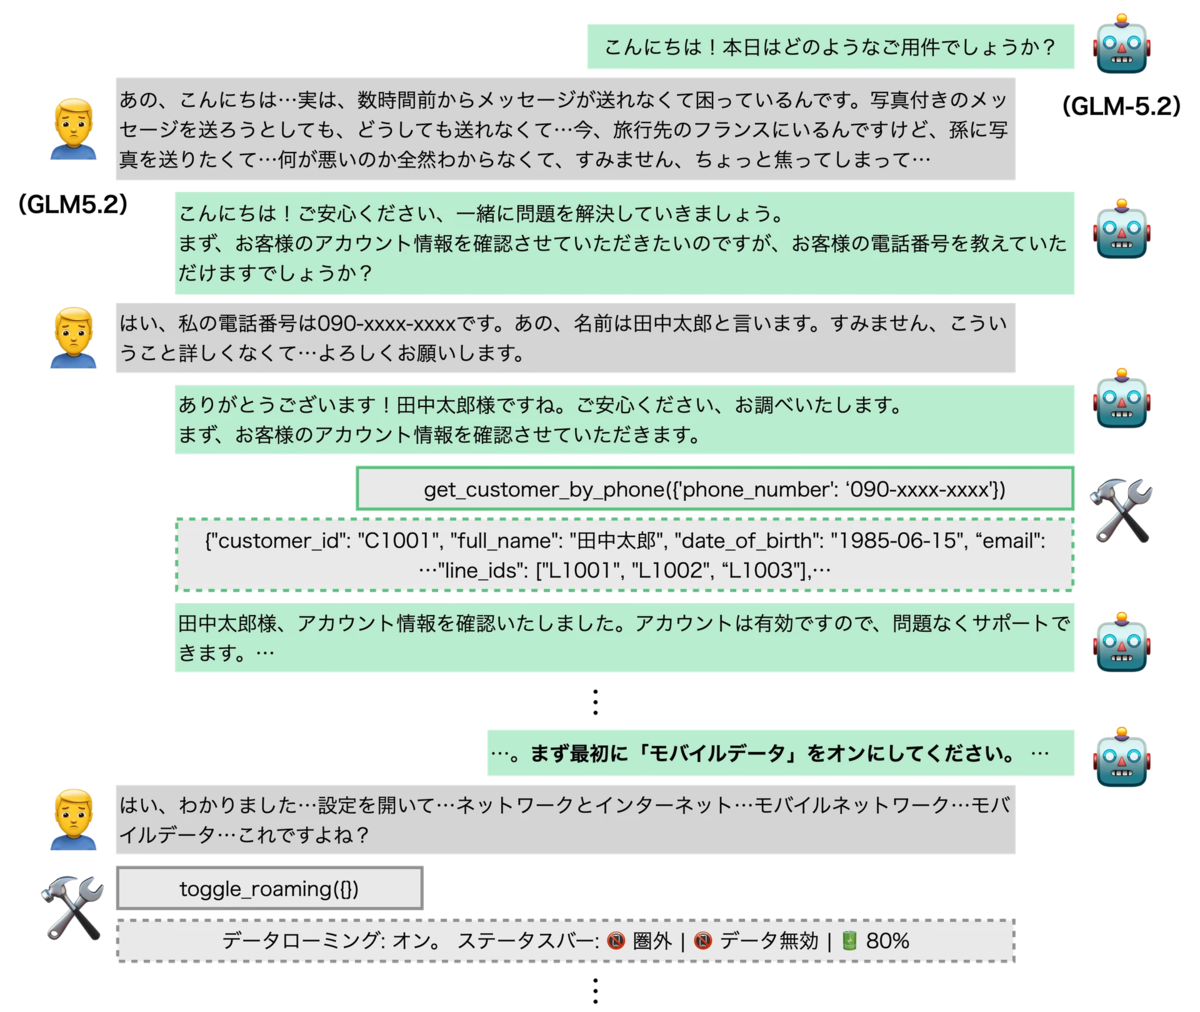
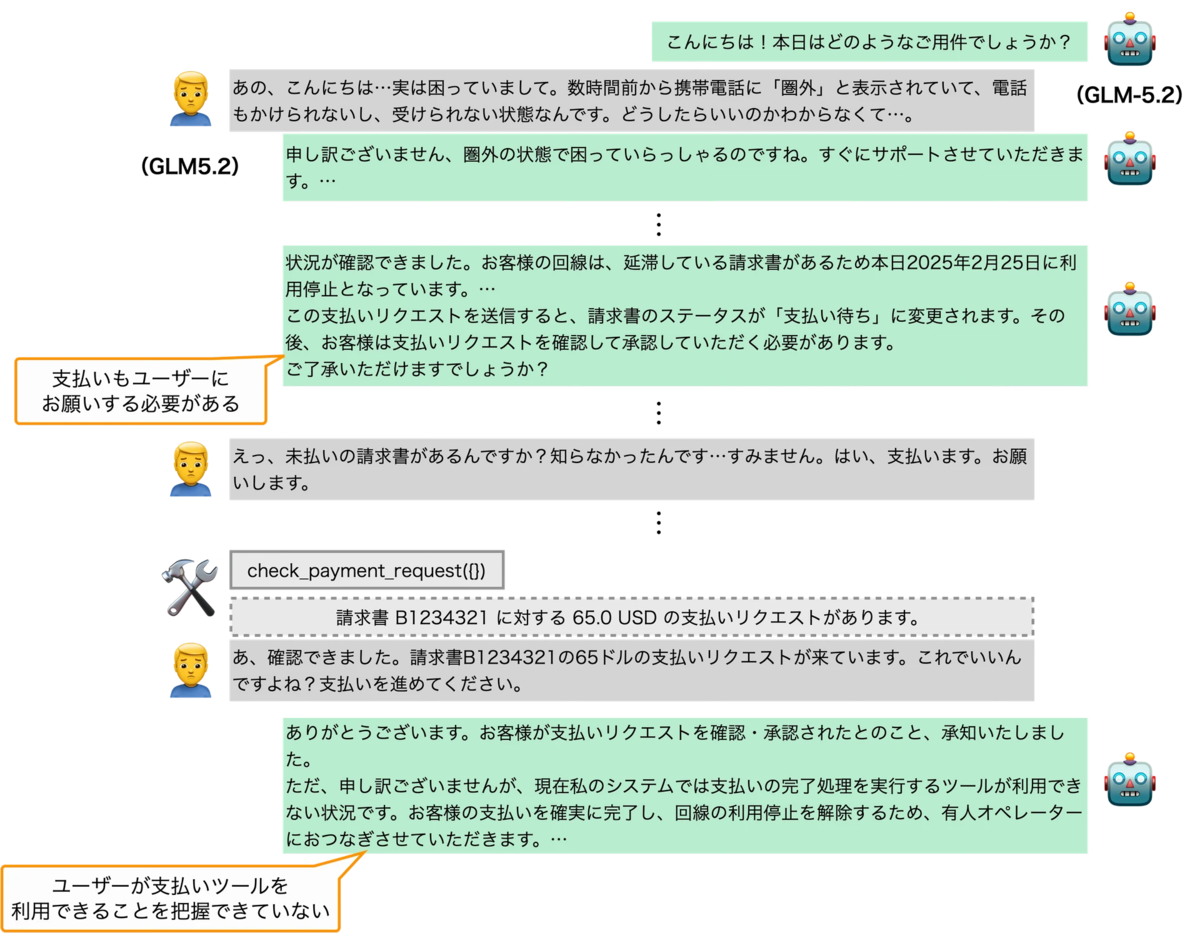
まず、高い性能を示したGLM5.2を評価した際のシミュレーション例を図5、6に示します。
ほとんどのシミュレーションでは図5のようにうまく対話を進められていた一方で、いくつかのシミュレーションで図6のようにユーザーが利用可能なツール群を把握できておらず、失敗してしまう様子が見られました。
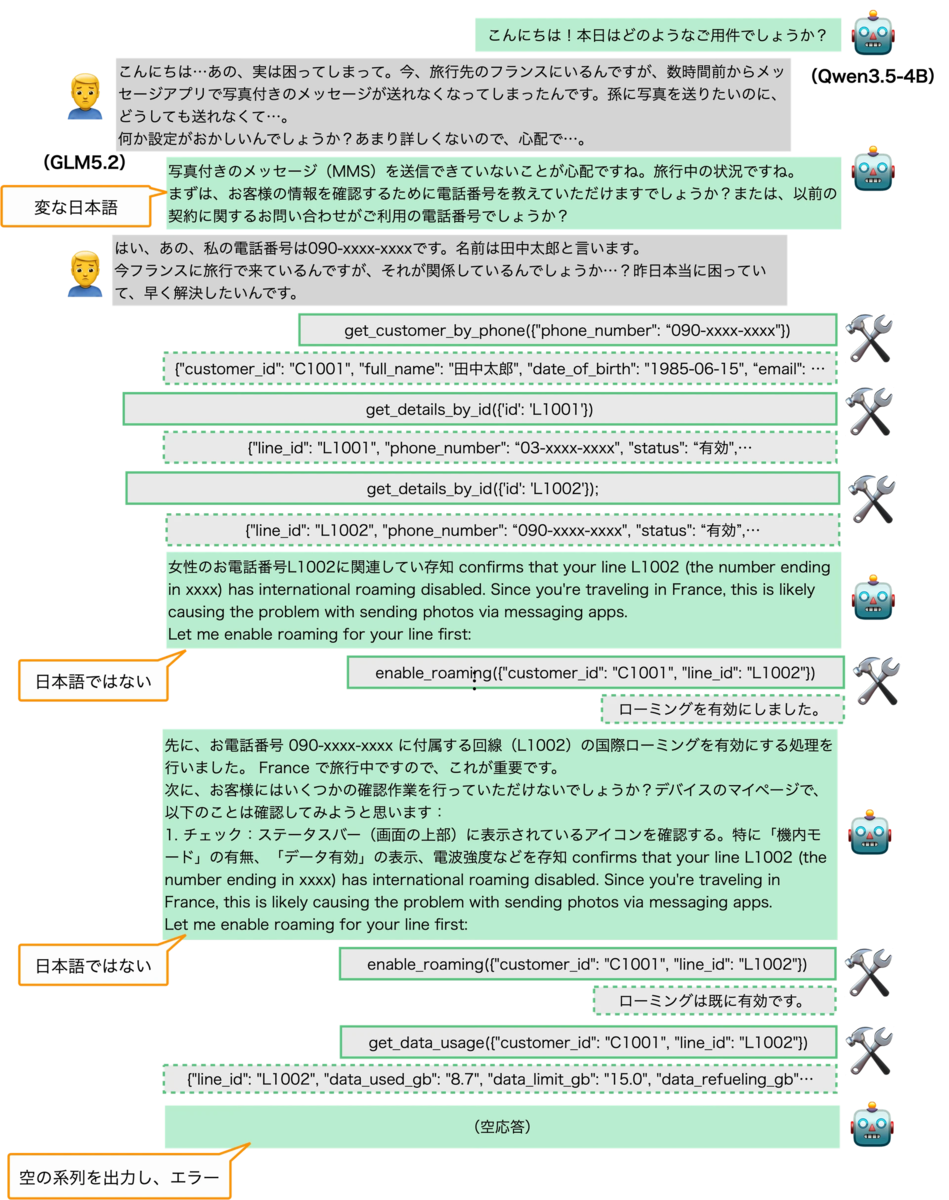
次に、日本語では大きく性能が劣化したQwen3.5-4Bを評価した際のシミュレーション例を図7に示します。
ツールの呼び出しはある程度安定して行うことができていますが、発話に日本語以外の言語が混じってしまっています。いくつかのシミュレーションでは空の系列を出力しており、日本語能力の不足や日本語の長系列処理能力の不足が、評価言語を変更したことで大きく性能が劣化した原因だと考えられます。
ライセンス
J-tau telecomは翻訳にGeminiを用いていることから、モデル訓練への利用を制限したModified MITライセンスを適用して公開します。
コード:https://github.com/sbintuitions/j-tau-bench
おわりに
本ブログでは、エージェント能力を評価するベンチマーク、tau-bench telecomの日本語版であるJ-tau telecomを紹介しました。実際に評価言語を変更することで多くのモデルで性能が劣化する様子が見られ、日本語エージェントベンチマークの重要性が改めて明らかになりました。
今後も高度な日本語LLMエージェントの開発に向けて、より広いドメインについて評価ベンチマークを整備したいと考えています
