はじめに
SB Intuitions株式会社の平子潤、松野智紀、今井悠人です。8月16日から18日にかけて、宮城県仙台市で開催された第21回言語処理若手シンポジウム(YANS2026)に、当社はプラチナスポンサーとして協賛いたしました。会場ではブース展示を行ったほか、共同研究の成果を含めて10件の発表とハッカソンへの参加を行いました。本記事では、シンポジウムの様子や気になった発表についてご紹介します。
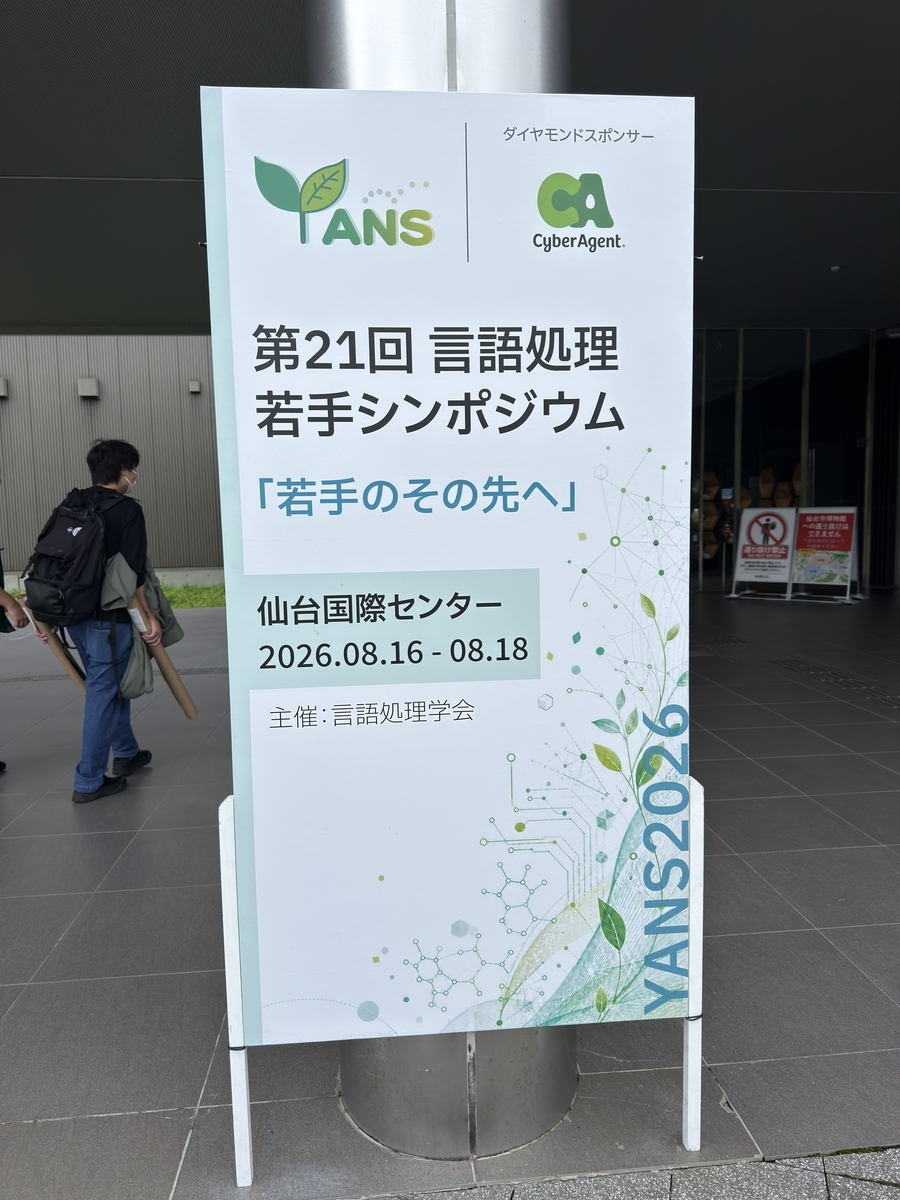
YANS2026の概要
YANSは、言語処理学会が主催する若手支援事業「言語処理若手シンポジウム」であり、自然言語処理および周辺技術に携わる若手のネットワーク構築や研究推進を目的として開催されています。
今年のYANS2026は仙台国際センターで開催され、8月16日にハッカソン、8月17・18日に本会議という計3日間の日程で行われました。参加者数571名、スポンサー団体数37団体という大規模なシンポジウムとなっており、特にスポンサー団体数は前年の28団体から約1.3倍に増加しています。NLP業界に注目する企業が年々増えていることがうかがえます。
ハッカソンでは、引用ハルシネーションの判定手法の開発という実践的なタスクに取り組みました。独自モデル部門と事例設計部門の2つのトラックが設けられ、各トラックとも6〜7人編成のチームが8つずつ、合計16チームが参加しました。
本会議では、5つのポスターセッションで合計248件の発表が行われました。どのポスターも多くの参加者で賑わい、活発な議論が交わされている様子が印象的でした。このほかにもカジュアル交流会やナイトセッション、チュートリアル、招待ポスターの発表なども行われ、発表以外の交流も盛んに行われていました。
スポンサーブースでは、弊社が開発したフルスクラッチLLMであるSarashina3 miniを用いたチャットAIのデモと、Sarashina3をベースに開発した翻訳モデルSarashina3 translateを用いた同時翻訳のデモを展示しました。いずれもご好評をいただき、貴重なフィードバックをいただきました。ブースにご来場いただいた皆様、ありがとうございました!
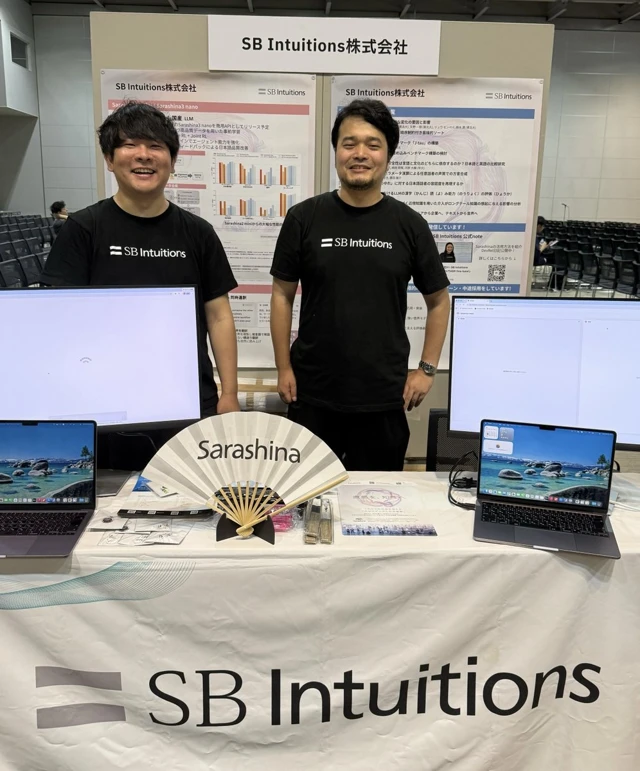
SB Intuitionsの発表
ここではSB Intuitionsの発表をいくつか紹介します。
日本語エージェントベンチマーク「J-tau」の構築 [1]
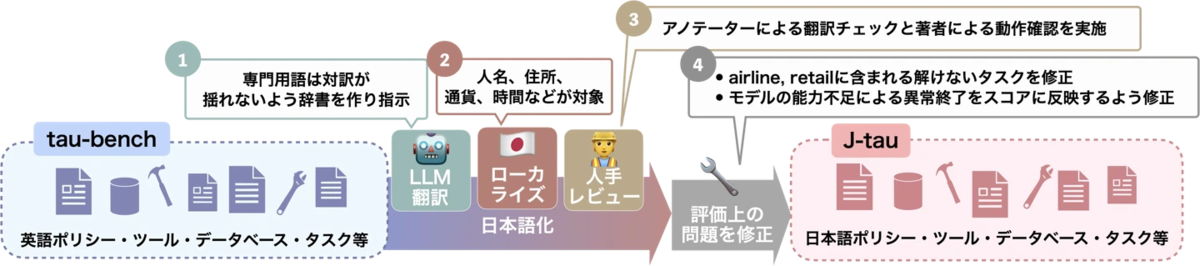
LLMのエージェント能力評価におけるベンチマークスコアは、評価に用いる言語に依存して変動することが知られていますが、日本語における整備は不十分です。そこで本研究では、日本語エージェント能力を評価するベンチマーク「J-tau」を構築し、公開しました。J-tauはtau-benchの日本語版で、airline, retail, telecomドメインを網羅しています。日本語化はLLMによる翻訳、人名などのローカライズ、人手レビューによって行いました。加えて、元のtau-benchに存在していた解けない問題の修正や、集計上の問題の修正を行なっています。構築したJ-tauで多様なモデルを評価し、日本語エージェント能力を明らかにしました。また、tau-benchでの評価結果との比較も行い、ほとんどのモデルで評価言語を日本語にすることでスコアが低下する傾向を確認しました。本研究についてはテックブログでも公開しています。
対話(たいわ)におけるLLMの漢字(かんじ)読(よ)み能⼒(のうりょく)の評価(ひょうか)[2]
大規模言語モデル(LLM)の漢字読み推定能力に関する研究は存在しますが、実運用における出力形式と、評価時の検証形式が乖離していることが多いのが現状です。また従来の評価データセットは、小規模な単一コーパスへ依存している・人間が日常的に読みを付与する文脈が考慮されていない、といった問題があります。そこで本研究では、複数コーパスから大規模にデータを収集することで、人間が読みを付与しやすい漢字を収集しました。そして、実際の出力に即した「漢字(読み)」という括弧書き形式などを採用することにより、より実態に近く多様な観点での漢字読み評価を実施しました。
本データセットを用いた評価の結果、言語モデルの漢字読み性能は評価の形式によって大きな影響を受けることが明らかになり、多様な表現形式での評価の重要性を示しました。さらに出力結果の分析から、LLMの読み推定におけるエラー要因は画数の多さや習得学年の高さといった人間にとっての難易度ではなく、固有名詞や読みの多様性が大きく影響していることを明らかにしました。本研究は奨励賞を受賞しました。
テキストの意味的ソート・順序制約付き意味的ソート [3]
大量のテキストリストを閲覧する際、関連性を考慮せずに並べられたリストはユーザーの認知負荷を増やしてしまいます。本研究では、テキストのベクトル表現の類似度に基づき、意味的に近いテキストが隣接するようにリストを並び替える手法を提案しました。この問題は、隣接するテキスト間のコサイン距離の総和を最小化するオープンパス問題として定式化され、これを巡回セールスマン問題(TSP)へと帰着させて、ヒューリスティックアルゴリズムを用いて近似解を求めることができます。さらに、実アプリケーションを想定して、投稿日時やいいね数などの既存の順序基準を維持しつつ、意味的な並び替えも同時に最適化する順序制約付き意味的ソートも提案しました。デモや実験を通じて提案手法の有効性を検証しました。本研究はデモ賞を受賞しました。
音声合成モデルのパラメータ演算による任意話者の声質での方言合成 [4]
音声合成の研究開発が進み、人間とわからないような生成もできるようになってきましたが、課題もまだ残っています。その一つが方言の音声合成です。⾳声エージェントでは利⽤者と同じ⽅⾔での応答が対話を円滑にします。一方でエージェントとしては声質は⽅⾔とは独⽴に選べることが望ましいですが、方言音声はデータが乏しく方言ごとの多話者データがないため、両者を分離して扱うことが難しいという問題があります。そこで、タスク間のパラメータ演算に着目し、「方言データで学習したLoRA重み」から「標準語データで訓練したLoRA重み」を減算してアクセント差分アダプタを抽出しました。これを推論時に適用することで、参照音声の声質を保ったまま方言のアクセントを付与した音声合成を実現しました。生成した音声の方言らしさのきちんとした評価はこれからですし、語彙の方言化はこの手法ではできませんが、これからも方言の生成に向けて引き続き研究を進めていきます。本研究は奨励賞を受賞しました。
他にも下記の発表を行いました。
- LLMは「日本語のゆれ」に対する日本語話者の容認度を再現するか, 高山 隼矢 (SB Intuitions)
- マルチターン対話の安全性は言語と文化のどちらに依存するのか?日本語と英語の比較研究, 五十里 渚 (早大), 福田 創 (早大), 高山 隼矢 (SB Intuitions), 綿岡 晃輝 (SB Intuitions), 河原 大輔 (早大)
- Knowledge Homophilyに基づく近傍知識を用いた介入がロングテール知識の想起に与える影響の分析, 板井 孝樹 (SB Intuitions), 奥山 陽平 (SB Intuitions), 平子 潤 (SB Intuitions), 廣淵 亮太 (SB Intuitions)
- 日本語マルチモーダル埋め込みベンチマーク構築の検討, 李 聖哲 (SB Intuitions), 小川 隼斗 (SB Intuitions)
- LLM最終隠れ層での急激な変化の要因と影響, 柴田 圭悟 (東北大), 小林 颯介 (東北大), 高瀬 翔 (東北大), 矢野 一樹 (東北大), リュウ センペイ (SB Intuitions), 鈴木 潤 (東北大)
- (招待ポスター)好奇心のおもむくままに:アカデミアから企業へ、テキストから音声へ, 水本 智也 (SB Intuitions)
気になった発表
YANS2026で印象に残ったポスター発表を紹介します。
形容詞が導く文化バイアス [5] (SB Intuitions スポンサー賞)
この研究では、Text-to-Imageモデルにおいて、同一の形容詞(例:『traditional』)を用いた場合でも、生成される画像が異なる文化コンテキストを反映する現象を分析しています。言語学的観点からは、価値判断を含む形容詞(例:『cheap』)と物理的特性を示す形容詞(例:『heavy』)では、文化圏間の表現の偏りが異なる点が興味深い結果でした。さらに、Stable DiffusionとQwen-Imageの比較から、前者が北米、後者が東アジアの文化圏にシフトしがちな生成傾向を示すという示唆が得られました。これは、フルスクラッチで基盤モデルを開発する弊社にとっても、文化的バイアスへの配慮が不可欠であることを示唆しています。萌芽的かつ潜在的課題を含む本研究は、分析の重要性という観点からスポンサー賞を授与するに至りました。
クロスモーダル意匠理解に向けた日本語意匠公報データセット構築とベンチマーク設計 [6]
日本国内における行政文書のVLMベンチマーク化は、llm-jpによる『HakushoBench』[7]などを通じて整備が進んでいます。この研究では、特許庁が公開する意匠公報データを活用し、説明生成や図面のキャプショニングを含む計8つのタスクが提案されるとともに、詳細な図面キャプショニングの人手評価のためのルーブリックが設計されました。特に、AI応用が期待される行政分野における、VLM/LLMベンチマーク化において興味深い事例の一つだと思われます。
LLM-as-a-Judgeにおける絶対評価と相対評価の整合性はスコア帯でどのように変わるか?[8]
この研究では、LLMを用いた文書評価における絶対評価と相対評価の不整合について、絶対評価のスコア帯ごとに分析を行っています。その結果、同じ絶対評価のスコア差であっても、低得点帯と高得点帯では評価の傾向が大きく異なることが明らかになりました。たとえば、高得点帯では絶対評価スコア間の数値的な近さが、低得点帯では人手評価でも差がつきにくい文書の曖昧さが、不整合の主因となっていました。一方で、順序バイアスといった評価形式に由来する要因は、スコア帯に関わらず広範に影響を与えることが示されました。本研究は、LLMを評価者として活用する上で、スコア帯と評価形式を考慮した評価設計の必要性を示唆しています。基盤モデル開発に取り組む弊社としても、評価結果を一様に解釈してはならないという点で、信頼性のある評価フレームワークを構築する上での重要な事例だと考えられます。
ハッカソン体験記
ハッカソンでは Hallucination Citation の検知に取り組みました。
これは生成AIを用いた論文執筆の広がりによって顕在化してきた「存在しない引用」の検知タスクです。
SB Intuitions からは参加者として松野、高山、矢野が、特別審査員(アドバイザ)として品川が参加しました。
参加者の3名それぞれのチームが独自モデル部門の審査員特別賞、事例設計部門の委員特別賞、審査員特別賞を受賞しました。
🏆受賞者一覧🏆#YANS2026 ハッカソンの表彰を行いました!
— YANS🌱言語処理若手シンポジウム (@yans_official) 2026年8月18日
おめでとうございます🎉 pic.twitter.com/zFQkM5fG63
コーディングエージェントの使用が明示的に認められた初めてのYANSハッカソンであり、各チームはデータ分析用のビューワーを開発したり複数手法を並列して開発してアンサンブルを行ったりと今までにないスピード感で非常に高レベルな手法の検証を行っていました。リッチな分析・実験ツールを序盤で簡単に整備できるようになった分、従来のハッカソンと比べて人の目でじっくりとデータやモデルの出力結果を眺めて考察する時間が確保できるようになったと感じました。
実務においても同じことが言えそうです。これまでは単発のタスクのために工数をかけてリッチなツールや実験スクリプトを作るのはスケジュールとの兼ね合いもあって憚られましたが、コーディングエージェントでそのハードルは飛び越えられます。コーディングエージェントは単なる工数削減ツールとしても便利ですが、これまで手をつけたくてもつけられなかった部分に手を伸ばすための土台として活用することで、より楽しく質の高い仕事ができるようになるのかもしれません。
最後に
YANSでは自然言語処理に加え、画像や音声に関する発表も盛んに行われており、多様なモダリティの盛り上がりを感じました。また、カジュアル交流会やナイトセッションなどを通じた交流も積極的に行われており、YANSならではの良さを感じました。
今後もSB Intuitionsでは、国内外の学術コミュニティに参加し最新の研究知見をコミュニティと情報交換しながら、日本の文化や習慣を理解した国産生成AIの構築、およびそのマルチモーダル化に精力的に取り組んでまいります。
採用情報
SB Intuitionsでは国産生成AIであるSarashinaの研究開発に加えて、日本語に強い音声モデルの開発やSarashinaの社会実装を進めています。ご興味がありましたら、以下の求人ページから是非ご応募ください。
参考文献
[1] 矢野 千紘 (SB Intuitions/名大), 平子 潤 (SB Intuitions), 廣淵 亮太 (SB Intuitions), “日本語エージェントベンチマーク「J-tau」の構築“, YANS2026
[2] 青野 広太郎 (SB Intuitions), 高山 隼矢 (SB Intuitions), “対話(たいわ)におけるLLMの漢字(かんじ)読(よ)み能⼒(のうりょく)の評価(ひょうか)“, YANS2026
[3] 福地 成彦 (SB Intuitions), “テキストの意味的ソート・順序制約付き意味的ソート“, YANS2026
[4] 三森 俊祐 (SB Intuitions/早大), 水本 智也 (SB Intuitions), 藤田 雄介 (SB Intuitions), “音声合成モデルのパラメータ演算による任意話者の声質での方言合成“, YANS2026
[5] 福井 優那(金大), 平尾 努(金大), 高村 大也(産総研), “形容詞が導く文化バイアス“, YANS2026
[6] 白田 連大(京都工繊大), 野中 尋史(愛工大), 延原 章平(京都工繊大), 河野 誠也(京都工繊大), “クロスモーダル意匠理解に向けた日本語意匠公報データセット構築とベンチマーク設計“, YANS2026
[7] Issa Sugiura, Shuhei Kurita, Yusuke Oda, Naoaki Okazaki, “HakushoBench: A Japanese Chart and Table VQA Benchmark from Governmental White Papers“, https://arxiv.org/abs/2606.01132
[8] 山下 伊織(一橋大), 木山 朔(一橋大), 伊藤 大陽(一橋大), 小町 守(一橋大), “LLM-as-a-Judgeにおける絶対評価と相対評価の整合性はスコア帯でどのように変わるか?“, YANS2026
