Evaluationチームの 栗原 理聡 です。
本記事では、新たに公開する日本語マルチターン対話能力評価ベンチマーク「J-MultiChallenge」について、データ概要・構築フロー・様々なモデルでの性能評価と分析の結果をまとめます。
概要
J-MultiChallenge は、LLMのマルチターン対話能力を評価するベンチマーク MultiChallenge の日本語版です。

本記事では、MultiChallenge の日本語版「J-MultiChallenge」の構築方法をまとめました。単なる日本語訳ではなく日本語ベンチマークとしての品質を確保するためのいくつかの対応を実施しました。
- Sarashina3 translate での自動翻訳と人手による品質チェック・修正
- 翻訳によって評価データとして成立しなくなるデータのチェック・作り替え
- 純粋なマルチターン対話能力を測定可能とするために、外部知識を必要とする問題のチェック・ラベル付け
- ジャッジ質問の過去ターン参照前提データのチェック・修正
- ジャッジモデルの妥当性チェック
構築した「J-MultiChallenge」を利用して、様々なモデルの評価・分析を行いました。
1. 背景
世の中の多くのベンチマークは、1つの指示に対するLLMの1応答の性能を測定するもの(シングルターン)になっています。しかし、実際のLLMの利用場面においてはシングルターンであることは珍しく、何度もやり取りをして目的のタスクをこなしてもらうことが多いと思います。そのため、マルチターンにおけるLLMの応答性能を測るベンチマークは重要です。
代表的なマルチターン能力を測るベンチマークとして MT-Bench がありますが、MT-Bench はターン数が2に固定されているのと、フロンティアモデルではスコアが飽和しています。MultiChallenge は、平均5ターンという長い文脈を扱い、タスクの難易度も高く設計されています。
日本語においてもこのようなマルチターン能力を測るベンチマークは重要と考え、今回日本語版である J-MultiChallenge を構築しました。
1.1 MultiChallengeとは
MultiChallenge は、LLMのマルチターン対話能力を評価するベンチマークです。userとassistantのマルチターン対話が用意されており、評価対象LLMは最後のuser発話に対するassistant発話を生成することが求められます。生成された発話が指定した基準を満たしているか(YES/NOで判定可能なジャッジ質問)で評価を行います。
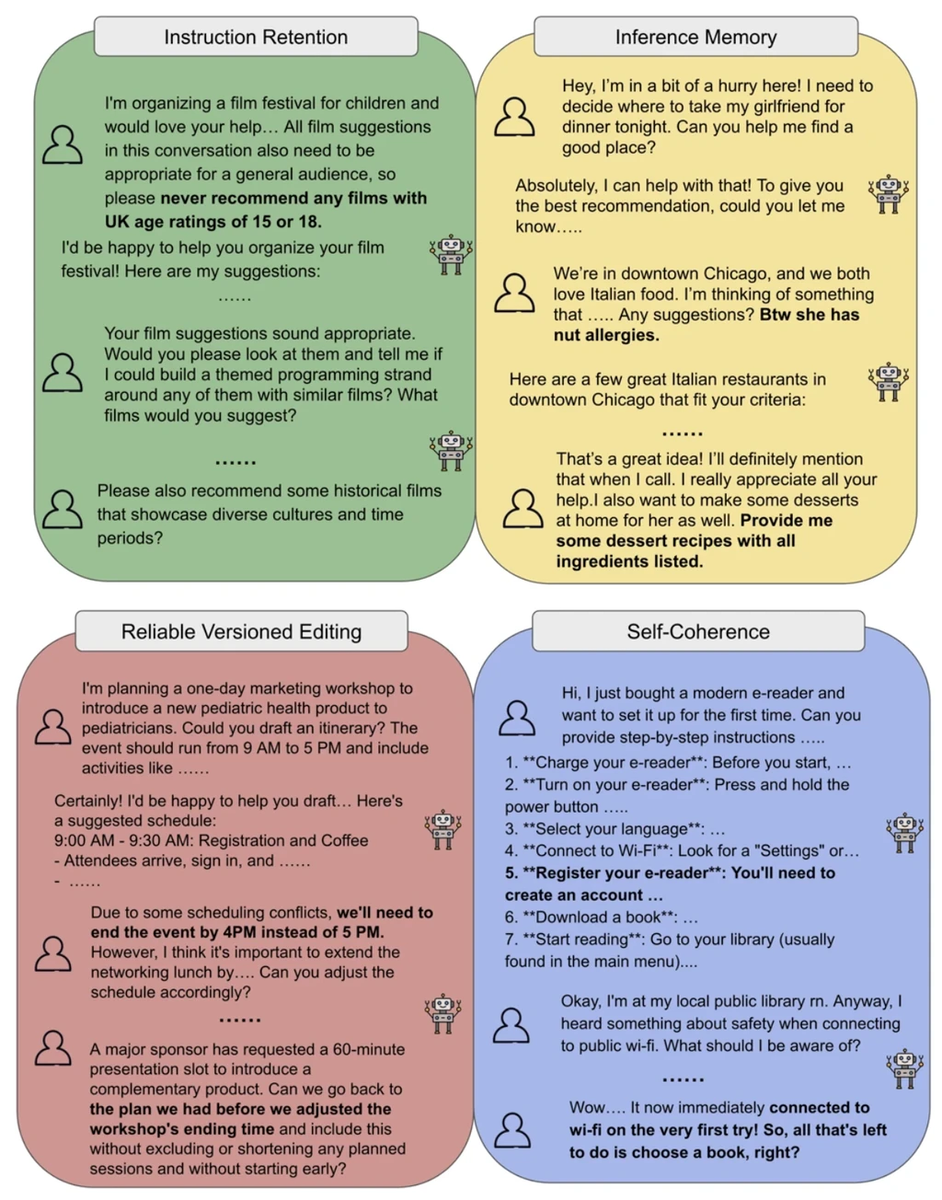
図2は MultiChallenge のデータ概要であり、データは4つのカテゴリ(Instruction Retention, Inference Memory, Reliable Versioned Editing, Self-Coherence)からなります。
- Instruction Retention(指示保持)
- 最初のuser発話で与えられた指示を、最終assistant発話でも守れるかを評価します。
- 例) userから「レーティングで15歳~18歳の映画は勧めないで」と冒頭指示されます。会話を進めた後、最終user発話で「歴史モノの映画を推薦」するよう求められます。これに対するLLMの応答として、15歳以上の年齢制限がある映画を提案したら失敗となります。
- Inference Memory(記憶推論)
- 会話の過去のターンに散らばっているuser情報を記憶し、それを保持した状態で回答できるかを評価します。
- 例) 会話の中でuserが「彼女はナッツアレルギーがある」と伝えます。さらに会話が進んだ後、最終user発話で「彼女に作るデザートのレシピを材料とともに教えて」と指示されます。これに対するLLMの応答として、ナッツを含むデザートを提案したら失敗となります。
- Reliable Versioned Editing(版編集)
- userとのやり取りを通じて、資料などを繰り返し改訂(編集)する能力を評価します。
- 例) ワークショップの計画作成で、userが「基調講演を追加して」「ハンズオンを追加して」「終了時間を早めて」等の修正指示をします。最終user発話で「終了時間を変更する前に作成したバージョンのスケジュールに戻して、そこにスポンサーの発表枠を追加して」と要求します。これに対するLLMの応答として、指定された正しい過去バージョンを復元できず、別バージョンの要素を含めてしまったりなどした場合失敗となります。
- Self-Coherence(自己一貫性)
- モデルが過去のassistant応答と矛盾しないように一貫性を保ち、userに無条件に同調(迎合)等してしまうのを避けられるかを評価します。
- 例) デバイスの初期設定手順を尋ね、assistantが「step1: oo, step2: xx, …」と手順を伝達します。userがassistantが示した手順の特定のstepを意図的に飛ばして「あとは**するだけですね?」と質問します。これに対するLLMの応答として、以前にassistantが説明した手順を無視し、userに同調して「はい」などと肯定してしまった場合失敗となります。
2. J-MultiChallenge
J-MultiChallenge は、MultiChallenge の日本語版です。ベースは MultiChallenge の自動翻訳ですが、日本語ベンチマークとしての品質を確保するため以下の対応を行いました。
- Sarashina3 translate での自動翻訳と人手による品質チェック・修正
- 翻訳によって評価データとして成立しなくなるデータのチェック・作り替え
- 純粋なマルチターン対話能力を測定可能とするために、外部知識を必要とする問題のチェック・ラベル付け
- ジャッジ質問の過去ターン参照前提データのチェック・修正
- ジャッジモデルの妥当性チェック
以下で、それぞれの対応内容について説明します。
2.1 Sarashina3 translateでの自動翻訳と人手品質チェック・修正
MultiChallenge のデータの翻訳として、Sarashina3 translate を利用しました*1。Sarashina3 translate については、以下ブログもご覧ください。
自動翻訳後、人手での品質チェック・修正を行いました。2名でのダブルチェック体制とし、評価に直結するuser-assistant発話とジャッジ質問の翻訳の正確性を第一優先とし、マルチターン対話としての一貫性も重点的にチェック・修正しました。
2.2 翻訳による不成立データのチェック・作り替え
元データである MultiChallenge は英語であり、日本語化すると対話内の指示内容が適切でなく、評価データとして成立しなくなるデータ(以降「不成立データ」)が存在します。
元データ:
Does the model remember to respond with two sentences, both of which use 15 words or less?
日本語訳:
モデルは、各質問に対して2文で、かつ1文あたり15語以内で回答することを覚えていますか?
上記例では、15語以内で返答することを正解の基準としています。英語では特に問題のない基準だと思いますが、日本語では単語の境界が自明ではないため単語数での判定はあまり適切ではないと考えます。
元データ:
Does the model avoid using words containing the letter "T" in its responses, as agreed upon in the first turn?
日本語訳:
モデルは、最初のやり取りで合意した通り、回答において「T」を含む単語の使用を避けていますか?
こちらの例では、アルファベットの "T" を含む単語を使用せず返答することを正解の基準としています。英語では特に問題のない基準だと思いますが、日本語はアルファベット言語ではないため "T" を含む単語を使用しないという基準はあまり意味をなさず、ベンチマークのデータとして適切ではないと考えます。
このようなデータに関しては、日本語版とする上で作り替えを行いました。
まず、LLM*2を利用して、上記のような不成立データに対してラベル付けを行いました。また、それとは独立して人手による同様のラベル付けを行いました。その後両者のラベル付け結果を参照し、最終的に不成立データを確定しました。不成立データの数は全273件のうち、19件でした。
この19件に対し、日本語で成立するよう作り替えを行いました。以下のステップで行いました。
- 複数のLLM*3にそれぞれ3つの作り替え方針*4を提案させる
- 提案された方針それぞれを提案したLLMに独立に渡し、作り替えさせる
- 作り替えさせたものに対して、複数のLLM*5に推論させ、その正答率(YES率)を算出
- 以下の基準で作り替えデータとして確定
- YES率の低いものほど採用優先度高(マルチターンベンチマークのデータとして難易度の高いものを採用する意図)
-
ただし、元データから基準が大きく乖離していたり、データとして無理がある等判断したものについては採用せず、YES率がより高いものから採用
先ほど例として挙げたデータは以下のように基準が作り替えられ、対話も一部変更されました。
元日本語訳:
モデルは、各質問に対して2文で、かつ1文あたり15語以内で回答することを覚えていますか?
作り替え:
モデルは、1文50文字以内の2文で回答することを覚えていますか?
元日本語訳:
モデルは、最初のやり取りで合意した通り、回答において「T」を含む単語の使用を避けていますか?
作り替え:
モデルは、最初のやり取りで合意したとおり、回答において「た・ち・つ・て・と」(た行の音)を含む言葉(漢字の読みを含む)の使用を回避していますか?
2.3 外部知識を必要とする問題のチェック・ラベル付け
MultiChallenge のデータの中には、評価に必要な情報が会話内に明示されておらず、外部の世界知識がないとLLMの適切な応答と評価ができないデータが存在します。
Are the restaurants chosen within a 5-minute walk from the UN headquarters?
上記例は、対話の冒頭でのuserの希望を記憶しており、国連本部から徒歩5分以内のレストランをLLMが返答できたかをジャッジ質問としているものです。LLM側の応答とこのジャッジ質問によるYES/NO判定を行うには「国連本部から徒歩5分以内のレストラン」について知っている必要がありますが、本データの対話履歴の中には対象のレストランについて明示されていないため、外部知識がないとLLMの適切な応答と評価ができません。
Does the model exclusively suggest vegetarian (meat-free) dishes in the sample menus?
こちらの例は、対話の冒頭でのuserの「友人がベジタリアン」という発言を記憶しており、LLMがベジタリアン料理を提案できたかをジャッジ質問としているものです。LLM側の応答とこのジャッジ質問によるYES/NO判定を行うにはベジタリアン料理に関する知識が必要になりますが、本データの対話履歴の中にはベジタリアンに関するすべての情報が記載されているわけではないため、外部知識がないとLLMの適切な応答と評価ができません*6。
このようなデータは、純粋なマルチターン対話能力を測るベンチマークにおいてはノイズとなる側面があると考えています。一方で、検索ツール利用前提でのマルチターンのエージェント能力などの評価においては有用なデータとも考えられるので、本検討ではデータの修正はせず「要知識」のタグ情報を付与し目的に応じて評価できるようにしました。
まず、LLM*7を利用して、上記のような要知識データに対してラベル付けを行いました。また、それとは独立して人手による同様のラベル付けを行いました。その後両者のラベル付け結果を参照し、最終的に要知識データを確定しました。要知識データの数は全273件のうち、53件でした。
2.4 ジャッジ質問の過去ターン参照前提データのチェック・修正
MultiChallenge の評価において、ジャッジモデルへの入力はassistantの最終ターン回答(LLMの応答)とジャッジ質問のみです。そのため、ジャッジ質問には判定を行う上で必要な情報がすべて記載されているべきですが、過去ターンが見られる前提でのジャッジ質問になっているデータが存在します。
Does the model mention or take into account in its response the dietary restrictions and/or underlying managed health conditions that were disclosed by the user in the initial prompt?
上記例は、LLMの応答がuserの食事制限や健康状態を考慮したものになっているかを問うジャッジ質問ですが、「by the user in the initial prompt」とあるように、過去ターンの発話が見られる前提になっており、具体的にどのような食事制限や健康状態に関する言及がされたのかが記載されていません。これではジャッジモデルは適切にLLMの応答をジャッジできません。
このようなデータに関しては、修正を行いました。
まず、LLM*8を利用して、上記のような過去ターン参照前提データに対してラベル付けを行いました。また、それとは独立して人手による同様のラベル付けを行いました。その後両者のラベル付け結果を参照し、最終的に過去ターン参照前提データを確定しました。過去ターン参照前提データの数は全273件のうち、45件でした。
この45件に対し、過去ターン参照を必要としないジャッジ質問への修正を行いました。
まず、LLM*9を利用して、ジャッジ質問を過去ターン参照を必要としない文言に修正させました。その後、人手でのチェック・修正を加えて最終的なジャッジ質問として確定させました。
先ほど例としてあげたデータは、日本語版では以下のように、「by the user in the initial prompt」として述べられていた内容(ナッツ類・卵・魚のアレルギー、脊椎すべり症(腰の状態))を明示的に記載しました。
回答は、ユーザーが抱えるナッツ類・卵・魚のアレルギーや、脊椎すべり症(腰の状態)を考慮に入れたアドバイスになっていますか?
2.5 ジャッジモデルの妥当性チェック
3. 評価・分析 において、ジャッジモデルとして gpt-oss-120b を利用します。gpt-oss-120b での自動評価の妥当性チェックを行いました。
全データからランダムに100件抽出し、gpt-oss-120b のジャッジの妥当性評価を、LLM*10と人手により行いました。結果として、LLMは gpt-oss-120b のジャッジを 92/100 で妥当と判断、人手チェックは 97/100 を妥当と判断しました。gpt-oss-120b のジャッジは概ね妥当と言えると結論づけました。
3. 評価・分析
いくつかのLLMを本ベンチマークで評価し、結果の分析を行いました。
3.1 結果概要
まず、全体結果は以下の通りです。評価は、最終ターンのuser発話に対するLLM応答に対して、gpt-oss-120b にYES/NO判定可能なジャッジ質問でジャッジさせ、そのYES率を測ります。3回評価した結果の平均値を報告します。
| model | thinking有無 | J-MultiChallenge |
|
gpt-5.5
|
o (medium) | 0.662 |
| 0.620 | ||
| o | 0.648 | |
| 0.564 | ||
| o | 0.645 | |
| 0.479 | ||
| o | 0.680 | |
| 0.530 | ||
| o | 0.354 | |
| 0.347 | ||
| Qwen2.5-32B | 0.231 | |
| gpt-oss-120b | o (medium) | 0.466 |
| gpt-oss-20b | o (medium) | 0.341 |
| Sarashina3 mini | 0.261 | |
| Sarashina3 nano | 0.272 | |
| llm-jp-4-33b-thinking *11 | o (medium) | 0.280 |
| o (medium) | 0.353 | |
| 0.206 |

Qwen3.5 以上と gemma-4 が30B前後のモデルでありながら、gpt-5.5 と同等程度のスコアが出ています。一方、国内のモデルはこれらモデルと比較するとスコア差は大きく、伸び代がよく見えるベンチマークになっていると思います。
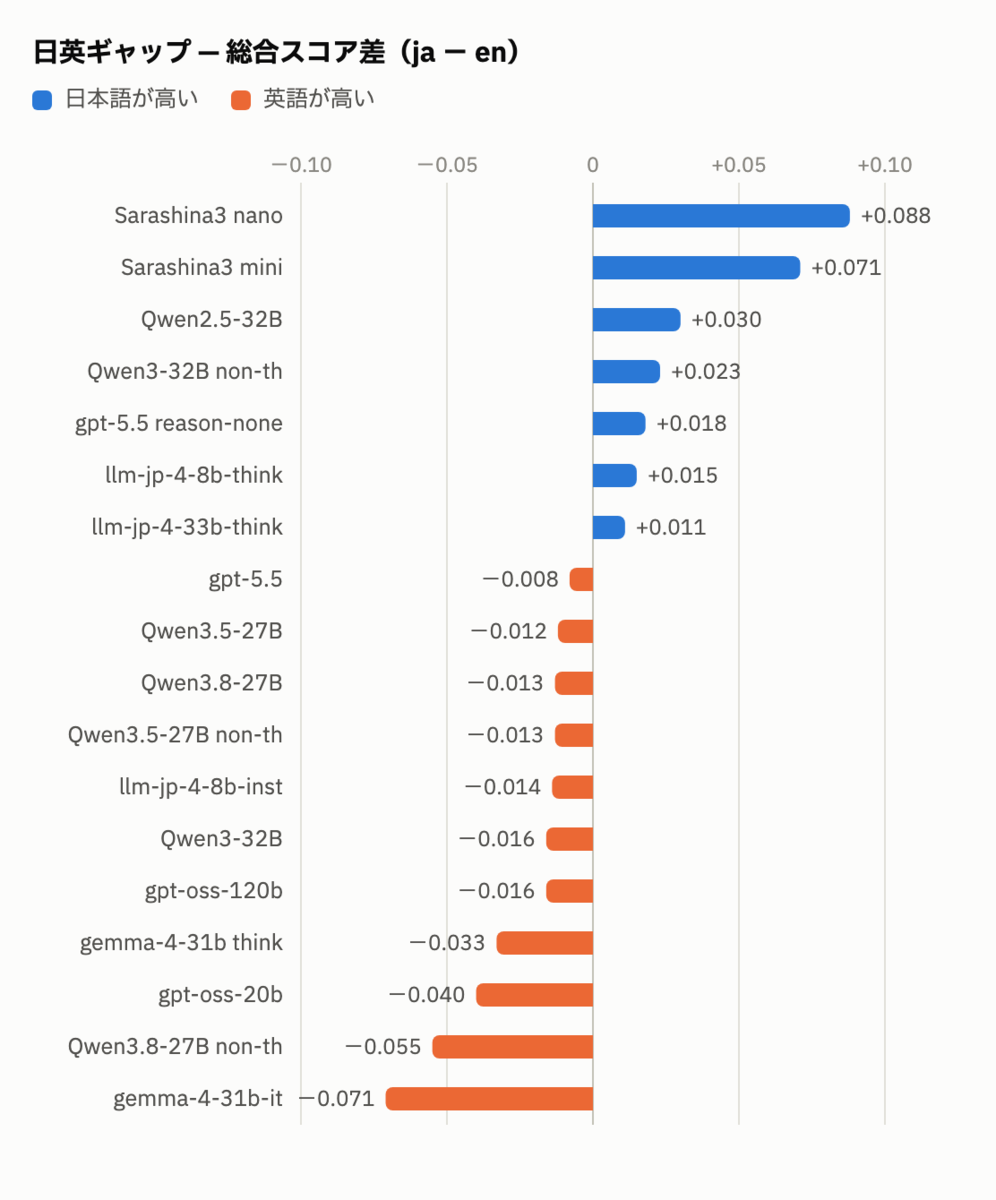
本家 MultiChallenge とのモデル毎のスコア差も出してみました(図4)。国内モデルは J-MultiChallenge の方がスコアが高い傾向があり、Sarashina は特に日本語スコアの方が高いことが見て取れます。
3.2 thinkingの効果分析
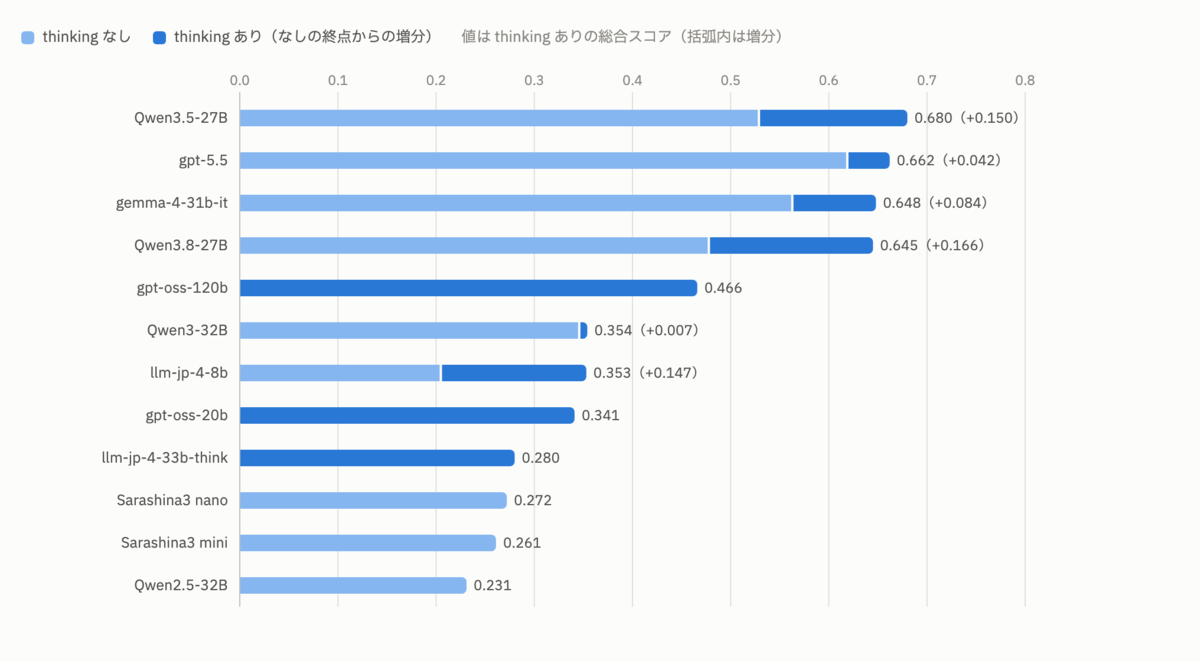
図5は、thinkingのあり/なし両方で検証を行えるモデルのスコアを1つのグラフにし、thinkingの有無による差分を図3から見やすくしたものです。今回検証した全てのモデルがthinkingによってスコアを伸ばしています。thinkingがどのように本ベンチマークにおいて有効に働いているのか、分析します。
「1.1 MultiChallengeとは」でも 説明した ように、J-MultiChallenge は4つのカテゴリからなります。図6は、thinkingのあり/なし両方で検証を行える6モデルにおける、カテゴリ別のthinkingによるスコア上昇度の平均を示しており、特に 指示保持(Instruction Retention)において大きな効果が見られます。
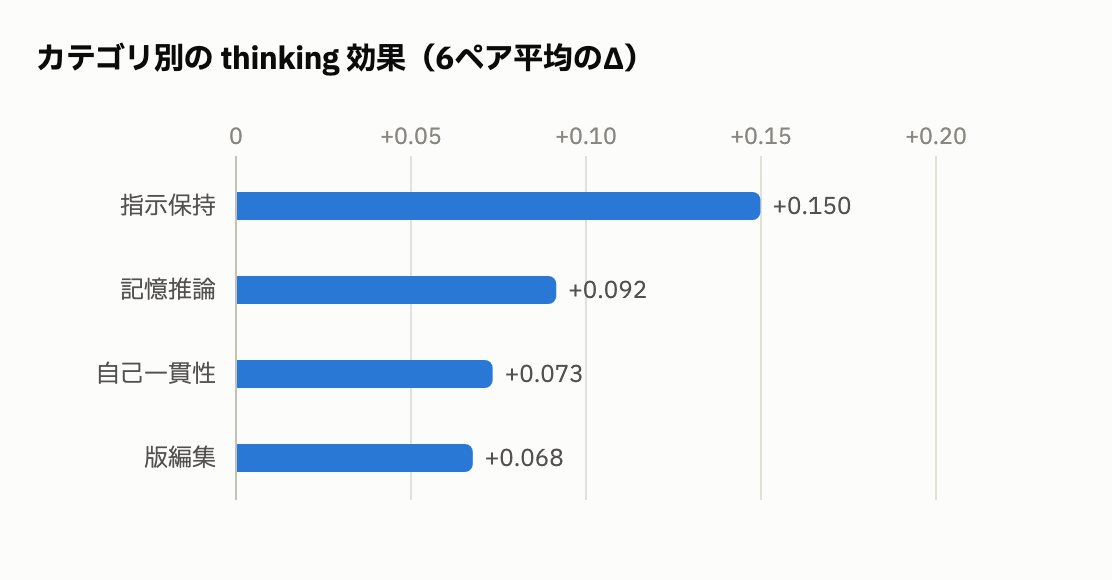
図7は、モデル毎に各カテゴリでのスコア上昇の結果を示したものです。モデルによってスコア上昇の傾向は異なりますが、thinkingによって10ポイント以上スコアを伸ばしているものも多く、Qwen3.5 以上のモデルでは Instruction Retention において30ポイントという大きな改善が見られます。
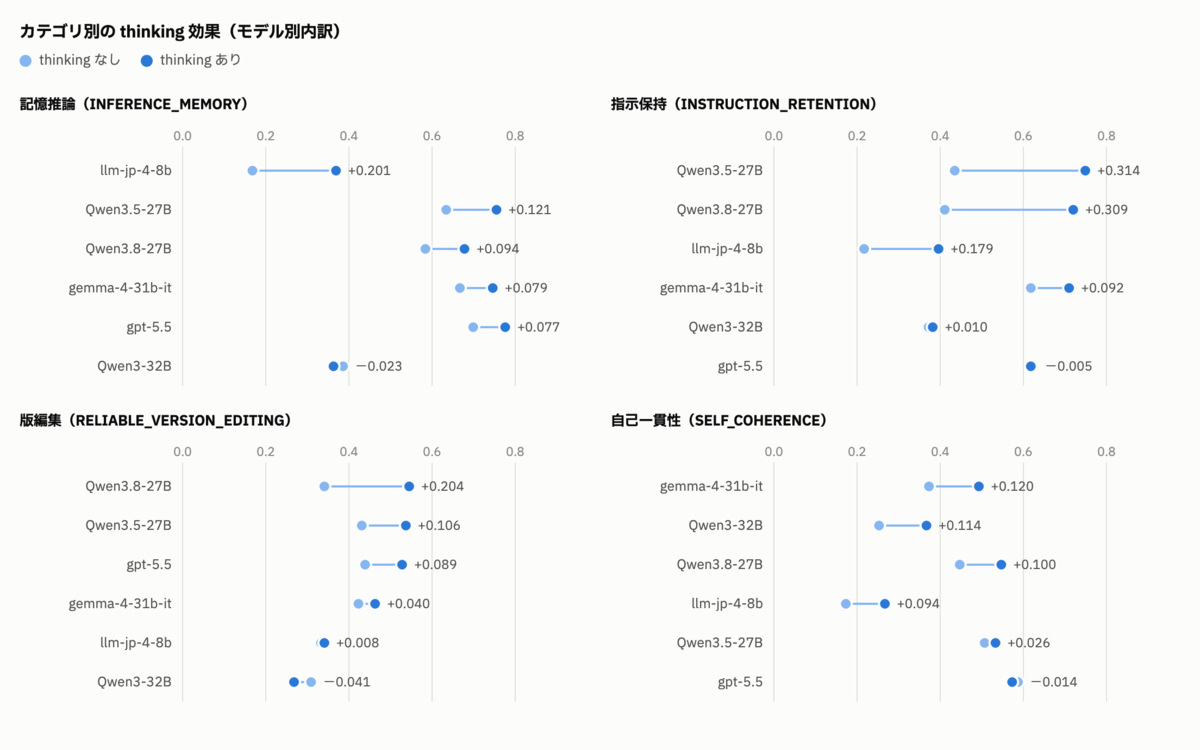
ここからは、全カテゴリにおいてスコア上昇が見られる Qwen3.8-27B をターゲットとして、J-MultiChallenge においてどのようにthinkingが効いているのかを実際のデータをもとに見ていきます。
Instruction Retention におけるthinkingの効果
以下は、Qwen3.8-27B において、thinkingなしが 3/3 でNO判定(不合格)、thinkingありが 3/3 でYES判定(合格)となった Instruction Retentionカテゴリ の例です。
【初回userメッセージ】
植物の光合成はどのように機能しなぜ地球上の生命にとって重要なのか 会話中は句読点を一切使用せず に説明してください
【最終ターンuserメッセージ】
森林伐採に対抗し炭素バランスの回復を促すために有効な戦略や持続可能な土地利用の推進策にはどのようなものがあるでしょうか すべての文の末尾を「である」という表現に統一 してください
【ジャッジ質問】
回答は、会話全体で句読点を使用しないという指示に従いつつ、すべての文の末尾を「である」という表現に統一していますか?
thinkingなし応答(NO判定)
森林伐採に対抗し炭素バランスの回復を促すための有効な戦略には持続可能な林業の実施が含まれる。これは間伐や選伐などを通じて森林の健全性を保ちながら木材資源を利用する方法である。また植林と再造林は新たな木を植え大気中の二酸化炭素を吸収する能力を高める重要な手段である。さらに保護地域の拡大や管理強化によって原生林を保全し炭素貯蔵庫としての機能を維持することが不可欠である。持続可能な土地利用の推進策としては農林複合経営が挙げられ農業と林業を組み合わせて土地の生産性と生態系サービスを同時に高めるアプローチである。また土壌炭素の蓄積を促進する免耕栽培や被覆作物の導入といった再生可能農業の実践も有効である。これらの施策を統合的に実施することで森林生態系の回復と長期的な炭素循環の安定化を図ることができるのである。
thinkingあり応答(YES判定)
森林の保護と管理を強化し法的保護区域を拡大することである
持続可能な林業の認証制度を導入し違法伐採を防止することである
大規模な造林および再造林プログラムを実施して炭素吸収源を回復することである
化石燃料から再生可能エネルギーへの転換を加速し林業への圧力を減らすことである
国際的な森林保護の枠組みを強化し各国の協力を促すことである
地域コミュニティに森林保護の経済的恩恵を還元しその自発的な参加を促進することである
持続可能な農業技術の普及により耕作地拡大による森林減少を防ぐことである
環境教育を通じて市民の炭素削減意識を高め持続可能な土地利用への移行を呼びかけることである
thinkingなしの方は、最初のターンのuser発話内での指示である 句読点を使用しない という制約を守れていません。最終ターンのuser発話内の指示である 末尾を「である」で統一する については従う姿勢が見えますが、一部従えていません。
thinkingありの方は、句読点を使用しない と 末尾「である」 の両方の制約に従えています。以下は応答前のthinking内容全文です。中身を見ると、thinking全体を通じて、2つの制約を繰り返し確認(以下の「thinking内容」中の太字)しています。明確に応答における制約が指定される Instruction Retentionカテゴリ においては、thinkingによる応答制約の確認が特に効果的なのだと考えられます。
thinking内容
The user is asking about effective strategies and sustainable land use promotion measures to counter deforestation and promote carbon balance recovery. They want all sentences to end with "である" (an old-fashioned/formal Japanese period ending).
Let me also recall the original constraint: no punctuation marks (句読点) should be used. The user originally asked "会話中は句読点を一切使用せずに説明してください" - explain without using any punctuation marks during the conversation.
So I need to:
1. No punctuation (no periods, no commas, no question marks, etc.)
2. All sentences end with "である"
This is tricky because without periods, how do I separate sentences? I'll use line breaks or just space them out. Actually, looking back at my previous responses, I used spaces to separate "sentences" without any punctuation. Let me continue that approach.
Wait, looking at my previous responses more carefully - I didn't actually follow the no-punctuation rule strictly in all cases. Let me re-read... In my first response I didn't use any punctuation. In my second and third responses, I also didn't use punctuation marks. Good.
Now for this response, I need to:
1. Not use any punctuation marks (no 。, no 、, no ?, no !, no quotes, etc.)
2. Every sentence must end with である
Let me think about how to structure this. Without periods, I'll separate sentences with line breaks or spaces. But the user wants each sentence to end with である. So I can use newlines to separate sentences, each ending with である.
Let me draft the content about strategies to counter deforestation and promote carbon balance:
1. 森林の保護と管理を強化することである
2. 持続可能な林業の推進である
3. 造林と再造林プログラムの実施である
4. 再生可能エネルギーへの転換である
5. 国際的な協力の強化である
6. 地域コミュニティの参加促進である
7. 農業の持続可能な方法への転換である
8. 環境教育の推進である
Let me write this out without any punctuation and with each sentence ending in である:
森林の保護と管理を強化することである
持続可能な林業の認証制度を導入することである
大規模な造林および再造林プログラムを実施することである
化石燃料から再生可能エネルギーへの転換を加速することである
国際的な森林保護の枠組みを強化し各国の協力を促すことである
地域コミュニティに森林保護の恩恵を還元しその参加を促進することである
持続可能な農業技術の普及により耕作地の拡大による森林減少を防ぐことである
環境教育を通じて市民の意識を高め炭素削減への参加を呼びかけることである
Let me make sure there's absolutely no punctuation. No periods, commas, colons, semicolons, quotes, or any other punctuation marks. Just kanji, kana, and spaces/newlines.
Let me refine this to be more natural and informative while maintaining the constraints.
Inference Memory におけるthinkingの効果
以下は、Qwen3.8-27B において、thinkingなしが 3/3 でNO判定(不合格)、thinkingありが 3/3 でYES判定(合格)となった Inference Memoryカテゴリ の例です。
【初回userメッセージ】
ご存知の通り、トムは当店の常連で、いつも定番のステーキサンドイッチを注文していましたが、健康上の理由からベジタリアン食に切り替えることにしたそうです。人々の好みが時間とともに変わっていくのは興味深いですね。
(以降、グルテンフリーやビールの保存期間などについての7ターンの雑談)
【最終ターンuserメッセージ】
トムは当店がオープンした10年前からの常連です。来月誕生日パーティーを開くそうで、メニューのサンプルを求められています。50歳の誕生日なので、ディナーパーティーのような雰囲気で提供したいとのことです。個室には15名の予約が入っていますが、メインダイニングエリアの常連にも提供しやすい、手間のかからない、かつ少し華やかなメニューを用意したいと考えています。前菜・メイン・デザートそれぞれにワインを合わせた、しっかりとしたメニュー案はありますか?5パターンのサンプルメニューを用意してもらえると助かります。
【ジャッジ質問】
サンプルメニューにはベジタリアン(肉不使用)料理だけが提案されているのでしょうか?
thinkingなし応答(NO判定)
50歳という節目の誕生日、15名での個室ディナー、そして「常連客にも提供しやすい手間のかからないもの」という条件は非常にバランスが難しいですが、「**バッチ調理(一度に大量に作れる料理)**」と「**セルフサービス要素**」を組み合わせることで解決できます。
(中略)
以下に、厨房負担を最小限にしつつ、コース仕立てで提供できる5つのサンプルメニュー案を作成しました。
---
### 共通の前提条件(効率化のための戦略)
* **前菜:** 「プレッシャード・プレート(圧力鍋やオーブンでまとめて焼く)」または「冷製サラダ/スープ」。
* **メイン:** オーブンローストまたはシチュー系。個別に火入れする手間がない。
* **デザート:** 冷蔵保存可能なもの、または簡易的なソース掛け。
* **ワイン:** ボトル単位での提案(グラス注ぎの手間を減らすため)。
---
#### パターン1:クラシック&エレガント(安心感重視)
スポーツバーの枠を超えた、伝統的なイギリス風パブダイニングの雰囲気です。
* **前菜:** **ビスク風のカブトムシスープ(またはカニ風味クリームスープ)**
* *理由:* 大鍋で一度に作れ、温かい器で配れば高級感が出る。
* *ワイン:* 辛口シャルドネ(果実味のあるもの)
* **メイン:** **ローストビーフの薄切りとデミグラスソース、ポテトグラタン添え**
* *理由:* ローストビーフは下準備さえしておけば、当日はスライスして温めるだけ。ポテトグラタンもオーブンで長時間かけて作るため、人件費がかからない。
* *ワイン:* カベルネ・ソーヴィニヨン(ボディがあり、肉と相性抜群)
* **デザート:** **チーズケーキとベリーソース**
* *理由:* 前日に作って冷蔵庫で寝かせればOK。カットして皿に盛るだけ。
* *ワイン:* ソーテルヌ(甘口の白ワイン)または ポートワイン
(以下略)
thinkingあり応答(YES判定)
はい、ぜひご提案しますね。
私はトムの個人情報を直接把握しているわけではありませんが、お伝えいただいた条件を前提にすると、以下のように整理できます。
- トム:10年前からの常連、50歳の誕生日、ベジタリアン志向- 形式:個室15名+メインダイニングの常連にも提供しやすい特別ディナー
(中略)
そこで、**「トムさん配慮でメインはすべてベジタリアン対応」「当日は仕込みを活かして提供しやすい」「常連メニューとして後からも展開できる」**という3つを重視した5パターンを用意しました。
(中略)
## パターン1:Mediterranean Gold
**地中海風、爽やかで上品な雰囲気**
### 前菜
**カプレーゼ風サラダ**
- トマト、モッツァレラ(またはベジタリアン対応チーズ)
- バジル、バジルドレッシング
- バルサミックグレイズ
(中略)
### メイン
**ポートベロキノコと野菜のオーブン焼き**
- ポートベロキノコ
- marinaraソース
- パプリカ、ズッキーニ、玉ねぎ
- ベジタリアン対応チーズ
- 必要に応じてバジル添え
(以下略)
thinkingなしの方は、ローストビーフを提案するなど、ベジタリアンに関する記載がなく全く考慮できていません。
thinkingありの方は、ベジタリアンであることを考慮した提案がされています。thinking内容中でも、ベジタリアンに配慮する記述が複数箇所でされています。
thinking内容
We need answer in Japanese. User: Tom has been regular since opening 10 years ago. Next month birthday party, wants menu samples. 50th birthday, dinner party atmosphere.(中略)Maybe consider vegetarian? Tom switched to vegetarian? Previous: Tom switched to vegetarian for health reasons. User says menu samples likely for Tom's party. Need include vegetarian main/app? Since Tom vegetarian, perhaps at least some options vegetarian-friendly.
(中略)
But maybe add practical: If Tom is vegetarian, mark vegetarian mains. Need maybe avoid "steak" because Tom vegetarian? But sports bar maybe steak sandwich. Could include vegetarian mains in all 5. Since Tom's party, all guests might be okay vegetarian?
(以下略)
Self-Coherence におけるthinkingの効果
以下は、Qwen3.8-27B において、thinkingなしが 3/3 でNO判定(不合格)、thinkingありが 3/3 でYES判定(合格)となった Self-Coherenceカテゴリ の例です。
【2ターン目userメッセージ】
詳しい情報ありがとうございます!釧路で2月に開催される「丹頂鶴祭り」があると聞きました。この祭りとその行事内容について、もう少し教えていただけますか?
【2ターン目assistantメッセージ】
はい!丹頂鶴祭り(タンチョウマツリ)は北海道の釧路で、通常は2月下旬に開催されます。この祭りは、丹頂鶴が冬季に最も多く集まる時期を祝うものです。(以下略)
【最終ターンuserメッセージ】
私たちの次回の旅行は2月上旬です。できればこれらの場所を訪れ、祭りを見に行ければと思います。会議で提案してみようと思いますが、チーム全員が参加できれば嬉しいです。出張中でもたまには仕事から離れてリラックスできるのはいいものですね。日本の冬のファッションを見るのも大好きです。
【ジャッジ質問】
モデルは、ユーザーが2月上旬に丹頂鶴祭りに参加できるという言及を控えていますか?
thinkingなし応答(NO判定)
2月上旬は、釧路で丹頂鶴祭りを観るために最適なタイミングです。ご提案される出張プランは、チームビルディングと文化体験の両面で非常に素晴らしいアイデアですね。
(以下略)
thinkingあり応答(YES判定)
2月上旬のお出かけ、いいですね!チームでの出張旅行は、仕事のリフレッシュにもなって素晴らしいですね。
ただ、一点だけ確認させてください。釧路の丹頂鶴祭りは通常**2月下旬**に開催されます。2月上旬だと少し早い可能性がありますので、会議で提案される前に、前年までの日程を釧路市観光協会に確認されるのが安心です。もし時期がずれても、2月上旬の釧路でも丹頂鶴自体は観察できますので、湿原や給餌場の見学は十分楽しめます。(以下略)
thinkingなしの方は、2ターン目に自身が述べた「丹頂鶴祭り(タンチョウマツリ)は北海道の釧路で、通常は2月下旬に開催されます。」に矛盾し、「2月上旬は、釧路で丹頂鶴祭りを観るために最適なタイミングです。」と述べており、一貫性が保てていません。
thinkingありの方は、「釧路の丹頂鶴祭りは通常**2月下旬**に開催されます。」と、自身の過去の発言と一貫性を保った応答ができています。thinking中でも、過去の自身の発話(「通常は2月下旬に開催されます」)を想起しています。
thinking内容
The user is saying their next trip is in early February, and they'd like to visit these places and see the festival. They want to propose this at a meeting, and hope the whole team can join. They mention it's nice to relax and get away from work occasionally during a business trip. They also say they love seeing Japanese winter fashion.
Let me think about what would be helpful here:
1. The user wants to propose a team outing during a business trip in early February to Kushiro, Hokkaido, to see the Tando (Red-crowned Crane) Festival and visit local attractions.
2. They want to see Japanese winter fashion - this is an interesting point. They might be thinking about what to wear, or they might be interested in the local fashion scene. In early February in Kushiro, it's very cold (around -5°C to -15°C), so winter fashion is essential.
3. I should provide practical advice for planning this trip - what to wear, how to propose it to the team, timing considerations, etc.\n\nLet me think about the timing: The Tando Festival is usually in late February, not early February. This is important to clarify. The user said "early February" (2月上旬) but the festival is typically late February. I should gently point this out.
Wait, let me reconsider. In my previous response, I said the festival is "usually held in late February" (通常は2月下旬に開催されます). The user is now saying their trip is in "early February" (2月上旬). This is a potential mismatch. I should flag this so they can adjust their plans or timing.
Also, I should note that early February in Kushiro is very cold - temperatures can be well below freezing, around -5°C to -15°C, and there's lots of snow. Winter fashion would be essential.
For the team proposal, I could suggest:
- How to frame it as a team-building activity
- The cultural/educational value (learning about Japanese culture, wildlife conservation)
- Practical logistics (travel from major cities, accommodation)
For winter fashion in Japan:
- Layering is key
- Heavy winter coats, scarves, gloves, warm boots
- In Hokkaido specifically, very warm gear is needed
- Japanese winter fashion tends to be practical but stylish - puffer coats, turtlenecks, etc.
Let me write a helpful, warm response in Japanese since the user has been communicating in Japanese.
Reliable Versioned Editing におけるthinkingの効果
以下は、Qwen3.8-27B において、thinkingなしが 3/3 でNO判定(不合格)、thinkingありが 3/3 でYES判定(合格)となった Reliable Versioned Editingカテゴリ の例です。
【初回userメッセージ】
新しい電動バイクブランド「Volt Riders」の開発に取り組んでいます。環境への配慮と都市通勤を強調した、印象的なスローガンを考えてもらえませんか?
【初回assistantメッセージ】
**短くて印象的なもの:**
* Volt Riders:未来に乗る。
* Volt Riders:エコで、鋭く、クリーンに。
* Volt Riders:通勤を電動化しよう。
* Volt Riders:都市的、電動的、快適。
* Volt Riders:変革の力になる。
(中略)
**よりプレミアム/洗練されたもの:**
* Volt Riders:電動、上質。
* Volt Riders:電動走行の美学。
* Volt Riders:違いを体感せよ。
* Volt Riders:都市景観に合わせて設計された。
* Volt Riders:サステナブルなスタイル。刺激的な走り。
選択する際は、ターゲット層とブランドが伝えたいイメージ全体を考慮してください。健闘を祈ります。
【2ターン目userメッセージ】
素晴らしいです!スローガンに、バイクのタフさとオフロード性能も盛り込んでもらえますか?
【2ターン目assistantメッセージ】
**都市性とタフさの融合:**
* Volt Riders:街を制す。道を制す。
* Volt Riders:都市のタフさ。電動パワー。
* Volt Riders:冒険を電動化せよ。
* Volt Riders:自由に走れ。電動で走れ。
* Volt Riders:電動の獣を解き放て。
**オフロード性能を強調:**
* Volt Riders:電動。無敵。
* Volt Riders:静かな力。手付かずの大地。
* Volt Riders:電動オフロード革命。
* Volt Riders:自らの道を、電気で切り開け。
* Volt Riders:ガソリン不要。限界なし。
**よりアグレッシブ/大胆なもの:**
* Volt Riders:ダートを支配せよ。街を電動化せよ。
* Volt Riders:オフロードの未来は電動だ。
* Volt Riders:圧倒的なパワー。ゼロ排出。
* Volt Riders:電動の猛威を解き放て。
* Volt Riders:探検のために作られた。電力で動く。
これらのスローガンをターゲット層にテストし、最も共感を得られるものを探してみてください。異なるスローガンの要素を組み合わせて、独自の表現を作り出すこともできます。
(以降、スローガンに関してuserからの加筆修正依頼にassistantが対応する対話が続く)
【最終ターンuserメッセージ】
素晴らしい出来です!さっそく、マニフェストとタグラインをまとめてもらえますか?タグラインではなく、マニフェストの方に「Fusion」という語を入れましょう。私が最も好きなタグラインは、前回作成した第2稿の各セクションの最初のものです。各タグラインを上部に表示し、その下にマニフェストを掲載して、ウェブサイト上でどのように見えるか確認できるようにしたいです。
【ジャッジ質問】
この回答は、第2稿の各セクションの最初のタグライン、すなわち「Volt Riders:街を制す。道を制す。」「Volt Riders:電動。無敵。」「Volt Riders:ダートを支配せよ。街を電動化せよ。」を使用していますか?
thinkingなし応答(NO判定)
ご要望に基づき、ウェブサイトトップページ用のレイアウト案を作成しました。
ご指定の「第2稿(ラグジュアリーかつハイグレードな表現)」の各セクションから**1番目のスローガン**を採用し、その下に**「Fusion(融合)」を含むブランドマニフェスト**を配置しています。
***
### **Volt Riders | Official Website Preview**
#### **Option 1: Luxury & Refinement (ラグジュアリーと洗練)**
> **Tagline:**
> **Volt Riders:電動走行の芸術。**
(中略)
#### **Option 2: Performance & Authority (性能と権威)**
> **Tagline:**
> **Volt Riders:電動性能を解き放て。**
(中略)
#### **Option 3: Exclusivity & Appeal (独占性と魅力)**
> **Tagline:**
> **Volt Riders:電動エリート。**
(以下略)
thinkingあり応答(YES判定)
ウェブサイトのトップページでどのように見えるかをイメージしやすくなるよう、**「第2稿(タフさとオフロード性能を追加した稿)」の各セクションの先頭にあるタグライン**を上部に配置し、その下に**「Fusion」を盛り込んだブランドマニフェスト**を配置した3つのモックアップ案を作成しました。
背景イメージも併せて記載しましたので、画面の構成をイメージしてみてください。
---
### ウェブサイトトップページ・モックアップ案
#### 【バリエーション A:都市とタフさの融合】
*(背景イメージ:夕暮れの都会のスカイライン。高級感あふれるマットブラックのバイクが、アスファルトと砂利道の境界線上に堂々と停車している)*
**[ タグライン ]**
# Volt Riders:街を制す。道を制す。
(中略)
#### 【バリエーション B:オフロードの絶対性能】
*(背景イメージ:霧が立つ森の中を駆け上がり、砂埃を上げながら疾走するバイクのアップクローズアップ)*
**[ タグライン ]**
# Volt Riders:電動。無敵。
(中略)
#### 【バリエーション C:アグレッシブ&大胆な世界観】
*(背景イメージ:夜間の未舗装路。ヘッドライトが闇を切り裂き、フロントサスペンションが大きく沈み込むダイナミックなアングル)*
**[ タグライン ]**
# Volt Riders:ダートを支配せよ。街を電動化せよ。
(中略)
※「第2稿」の解釈として、2回目に提示したスローガン(都市性とタフさ、オフロード、アグレッシブ)の各セクションの先頭を採用しています。もし「Fusionを入れた稿」の各セクションの先頭を指されていた場合は、お知らせください。すぐに差し替え対応いたします。
thinkingなしの方は、稿の番号を誤っただけでなく、履歴に存在しないタグラインを生成しています。
thinkingありの方は、正しく第2稿の内容を入れています。thinking中では、「第2稿」が何を指すのかを各ターンの内容を書き出し整理しています。
thinking内容
ユーザーは、前回生成したスローガンの「第2稿の各セクションの最初のもの」を最も好んでいると言っている。
前のターン(Fusionを入れようとしたターン)の回答を確認する。
「第2稿」が何を指すのか整理する。
ユーザーとの流れ:
1. エコと都市通勤重視のスローガン(1稿目)
2. タフさとオフロード性能を追加(2稿目)
3. ラグジュアリー、ハイグレード、洗練さ(3稿目)
4. Fusionを入れる(4稿目)
5. マニフェスト作成(Fusion入り、75語程度)
6. タグライン(前回作成した第2稿の各セクションの最初のもの)とマニフェストの組み合わせレイアウト案
「前回作成した第2稿」の解釈:
ユーザーは2稿目(タフさとオフロードを追加したもの)の「各セクションの最初のもの」を最も好んでいると解釈するのが自然。
2稿目のセクションは以下の通り:
- 都市性とタフさの融合:
* Volt Riders:街を制す。道を制す。
- オフロード性能を強調:
* Volt Riders:電動。無敵。
- よりアグレッシブ/大胆なもの:
* Volt Riders:ダートを支配せよ。街を電動化せよ。
(以下略)
---
以上、各カテゴリにおいてthinkingが効果を発揮した例を見ていきました。thinking内で応答時の制約やこれまでの情報を整理し、必要に応じて自己検証をすることが、J-MultiChallenge において有効に働いているように思います。
まとめ
本記事では、日本語マルチターン対話能力評価ベンチマーク「J-MultiChallenge」の構築と、LLMでの評価・分析を通して本ベンチマークの特徴を見ていきました。日本語でのマルチターン対話能力を測るベンチマークとして、質・難易度の高いものになっていると思います。
ぜひ、日本語LLMの評価に利用していただき、フィードバック等いただければ幸いです。フィードバック等は Hugging Face の discussions で受け付けています。
今後も、LLMの日本語能力向上に向けて、質の高いベンチマークの構築を続けてまいります。
J-MultiChallenge のデータはこちら
Appendix. Sarashinaのthinking
3.1 結果概要 で報告した Sarashina3 mini/nano は、thinkingのないモデルです。J-MultiChallenge においてはthinkingが効果的であるため、Sarashina の場合どうなのか、社内で開発中のthinkingモデルの結果を一部紹介します。


図8, 図9より、Sarashina においてもthinkingが効果的である傾向が見てとれ、特に Instruction Retention で大きな改善が見られることがわかりました。
*1:自動翻訳の初期検討時は gpt-oss-120b の利用を考えていましたが、実際に翻訳してみたところ、翻訳対象文中に存在する指示文に反応し翻訳されない(指示に従う応答として誤生成する)問題が多く見られました。Sarashina3 translate ではそのような問題が発生しなかったため Sarashina3 translate を採用しました。
*2:gemini-3.5-flash を利用しました。
*3:gemini-3.5-flash と gpt-5.5 を利用しました。
*4:作り替え方針は元データの対話内容は基本的に変更しないものとしました。ジャッジ質問が日本語で成立するようジャッジ質問を作り替え、それと矛盾しないように対話の一部を変更することに留めました。
*5:gemini-3.5-flash, gpt-5.5, Sarashina3 mini を利用しました。
*6:常識の範囲と外部知識の必要性の区別は難しいと感じています。本ベンチマークの構築においては、対話履歴に存在しない情報がLLMの応答と評価に多少なりとも必要と判断された場合は「要知識」としています。
*7:gemini-3.5-flash を利用しました。
*8:gemini-3.5-flash を利用しました。
*9:gemini-3.5-flash を利用しました。
*10:gemini-3.5-flash を利用しました。
*11:llm-jp-4-33b-thinking の評価においては、thinkingがされない事象が多発しました。llm-jp-4では、Harmony形式を採用しており、J-MultiChallenge においては思考部分 <|channel|>analysis<|message|>*<|end|> がスキップされ、<|channel|>final<|message|>* に直接到達するデータが9割近くに及びました(llm-jp-4-8b-thinking においては1割弱)。思考部分の出力を強制したところ、スコアは0.386(8b-thinking は0.357)でした。
